https://github.com/ShinyJay2/qwen3.5-korean-lora-finetune GitHub - ShinyJay2/qwen3.5-korean-lora-finetune: LoRA fine-tuning of Qwen3.5-0.8B on Korean instruction data (ko_alpaca_data) wiLoRA fine-tuning of Qwen3.5-0.8B on Korean instruction data (ko_alpaca_data) with KoBEST benchmark evaluation - ShinyJay2/qwen3.5-korean-lora-finetunegithub.com
LLM 관련 base knowledge recap의 의미로, 이 게시물을 작성한다. 다음의 글을 참조하면 좋을 것이다.https://www.krupadave.com/articles/everything-about-transformers?x=v3 Everything About TransformersA visual, intuitive deep dive into transformer architecture: history, design choices, and the why behind attention, masking, and positional encoding.www.krupadave.com History of Transformer 처음에 개발된 feed forward network는 no memory, n..
PINN에 이어서 DeepONet에 대해 다뤄보도록 하겠다. DeepONet은 데이터로부터 함수와 함수 간의 매핑인 '연산자(Operator)'를 직접 학습하여 물리적 시스템의 해를 근사하는 신경망 모델이다.입력 함수의 정보를 담는 브랜치(Branch) 네트워크와 출력 위치 정보를 처리하는 트렁크(Trunk) 네트워크의 내적(Inner product) 구조를 통해 non-linear 관계를 효율적으로 표현한다.PINN이 solution을 찾는 것과 달리, DeepONet은 해를 구하는 알고리즘 자체를 학습하기 때문에 다양한 초기 조건이나 경계 조건에 대해 generalization이 가능하다. https://arxiv.org/abs/1910.03193 DeepONet: Learning nonlinear ..
오늘은 physics informed network의 대표작인 PINN에 대해서 간단히 다뤄보려고 한다. PINN(Physics-Informed Neural Networks)은 물리 법칙을 딥러닝 모델의 학습 과정에 직접 통합하여, 데이터의 패턴뿐만 아니라 실제 물리적 원리를 함께 학습하는 프레임워크라고 할 수 있다. 주로 편미분 방정식(PDE)을 신경망의 손실 함수(Loss Function)에 포함시키는 방식을 사용하며, 이를 통해 모델이 물리적으로 타당한 해를 도출하도록 강제하는 방식이다.이 방식은 학습 데이터가 부족한 상황에서도 높은 예측 정확도를 유지할 수 있게 해주며, 공학적 시뮬레이션이나 복잡한 물리 현상(주로 데이터를 시뮬레이션 하는데 많은 resource가 들어간다)에 사용된다. https..
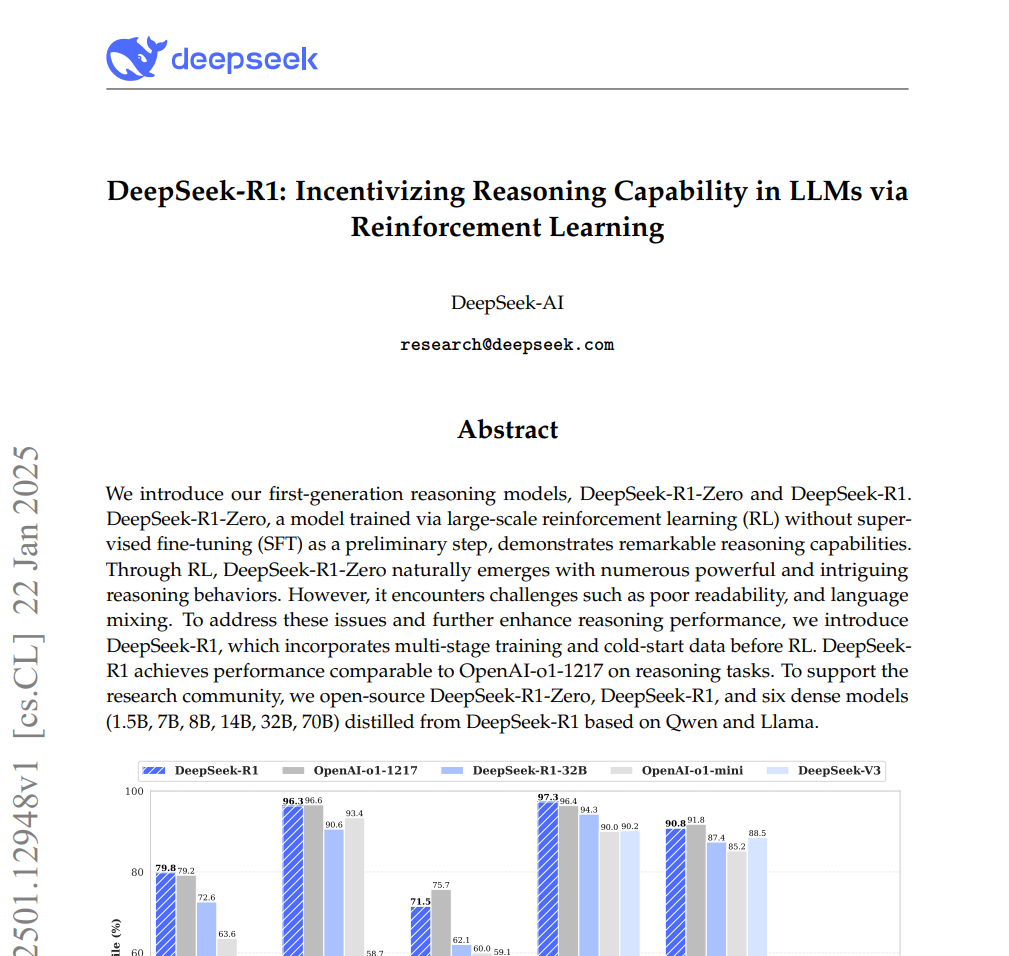
오랜만에 굉장히 설레는 논문 포스팅인 것 같다. 이 논문 이전에는 아무래도 미국 빅테크들의 LLM들만 주목받았었다면, DeepSeek가 R1을 공개하고 나서는 중국의 LLM 연구가 우수하다는 것을 전 세계에 알린 기점이 되었다고 생각한다. 실제로 엔비디아와 같은 주식이 폭락하기도 했고, 나 역시도 이 소식을 듣고 "진짜 중국이 이 정도로...?" 하면서 출시 당시 논문을 슬쩍 보기도 했었다. 실제로 순수 RL을 이용한 LLM incentivization은, 당시 RLHF가 최신 트렌드였던 업계에서 breakthrough가 되었다고 생각할 뿐만 아니라 강화학습의 활용성에 대해서도 다시 생각해보게 된 계기가 되었던 것 같다. 다들 참 대단하다. 나도 저런 연구자가 되고 싶다..ㅠ Main Contrib..